PPO(近端策略优化)用采样得到的奖励更新策略,同时通过裁剪目标限制单批数据上的更新幅度。本文只讲经典 RLHF 中的 PPO-Clip + GAE:回答正常结束,一个 Token 是一个动作,一段回答是一条轨迹。依据是 OpenAI 的 PPO 说明和 TRL v0.11.4 的经典实现;后者不是当前版本的 API 教程。
四个模型做什么
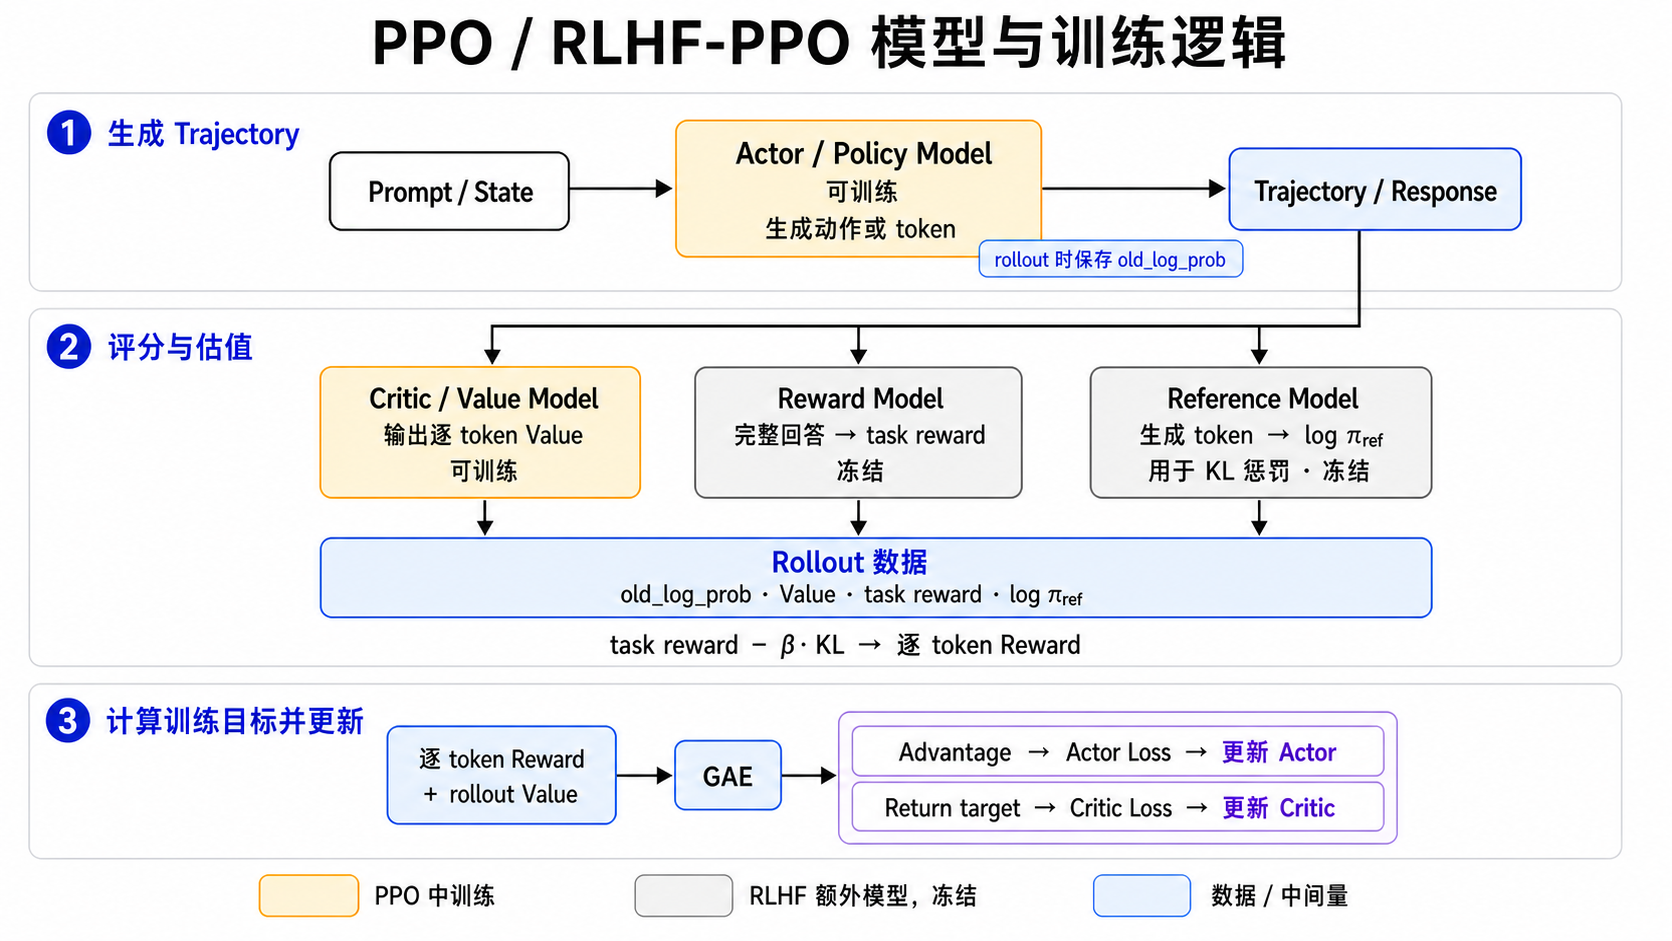
- Actor(训练):已生成的上下文 → 下一个 Token 的概率;负责生成回答。
- Critic(训练):当前上下文 → 预期的后续累计回报 $V(s_t)$。
- Reward Model(冻结):Prompt + 完整回答 → 回答分数 $R_{\mathrm{RM}}$。
- Reference Model(冻结):当前上下文 → Token 概率,供 KL 惩罚参照。
Actor 从 SFT 模型初始化;Reference 是冻结的初始策略。对 Prompt $x$ 和回答 $y_1,\ldots,y_T$,第 $t$ 步的状态是 $s_t=(x,y_{<t})$,动作是 $a_t=y_t$。采样时保存 Actor 对所生成 Token 的旧对数概率和 Critic 的旧价值,供同一批数据的后续更新使用。这里的采样旧策略会随下一批回答刷新,Reference 则保持冻结。来源:TRL v0.11.4
从回答分数得到 Token 优势
Reward Model 只给完整回答一个分数。经典实现同时比较采样策略与 Reference 在各个已生成 Token 上的对数概率,形成逐 Token 惩罚;回答分数加在最后一个有效 Token,而不是平均分给每个 Token:TRL v0.11.4 compute_rewards
$k_t$ 是采样 Token 的 KL 单样本估计,$\beta$ 控制惩罚强度,$T$ 是回答的最后一个有效位置。图中从回答分数到 Token 奖励的路径也对应这个放置方式。
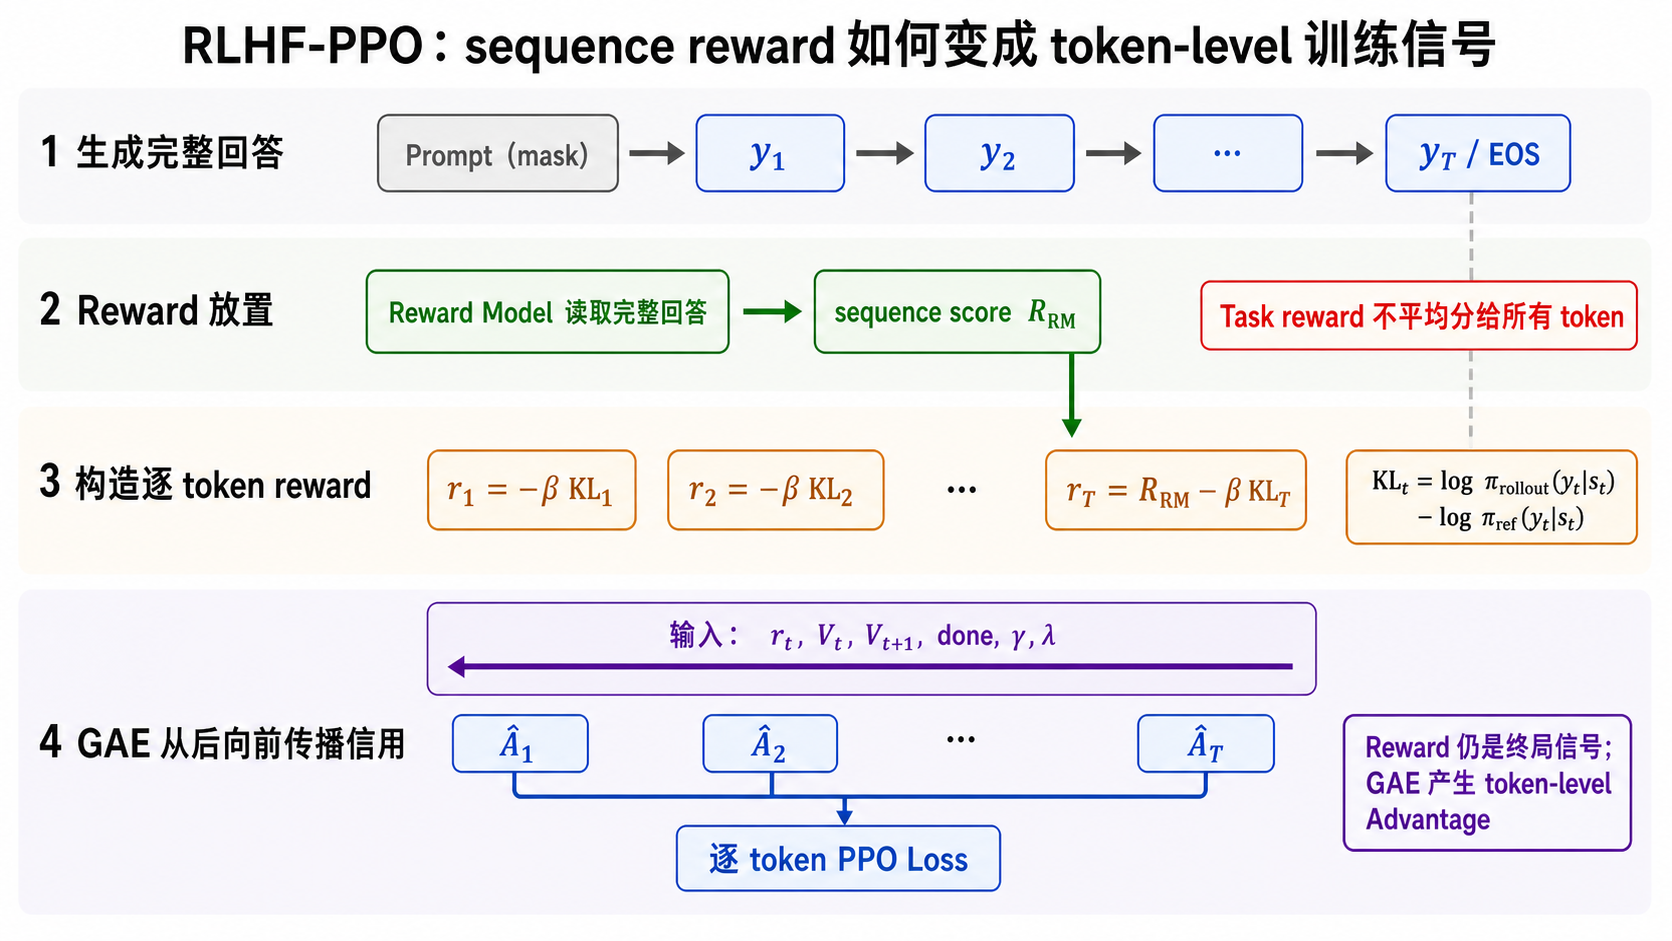
Critic 用旧价值估计每一步之后还会获得多少回报。对正常结束的回答,从末尾向前计算 GAE(广义优势估计):
$\gamma$ 折扣后续奖励,$\lambda$ 控制后续 TD 误差在优势中的权重;结束后取 $V_{\mathrm{old}}(s_{T+1})=\hat A_{T+1}=0$。上式的 $\hat A_t$ 是原始 GAE 优势,$\hat R_t$ 在其标准化前计算;TRL v0.11.4 随后将有效 Token 的优势标准化,用于 Actor 更新。下文的 $\hat A_t$ 指 Actor 实际使用的优势。回答分数虽只加在末尾,GAE 仍可将其影响传回前面的 Token。
PPO-Clip 如何更新 Actor
Actor 对这批已经生成的 Token重新计算概率,与采样时保存的概率比较。按照 PPO-Clip 的最大化目标:
$\rho_t$ 是新旧策略对同一 Token 的概率比,$\bar\rho_t$ 是裁剪后的概率比,$\epsilon$ 是裁剪幅度。Actor 最小化 $-\mathbb E_t[J_t]$,只对有效回答 Token 求平均:
- $\hat A_t>0$ 时,增大该 Token 概率会提高目标;当 $\rho_t>1+\epsilon$,该样本的 PPO-Clip 项梯度为零,不再推动该 Token 的概率继续增加。
- $\hat A_t<0$ 时,减小该 Token 概率会提高目标;当 $\rho_t<1-\epsilon$,该样本的 PPO-Clip 项梯度为零,不再推动该 Token 的概率继续降低。
例如 $\epsilon=0.2$:正优势 $\hat A_t=2$、$\rho_t=1.5$ 时,两项分别为 $3$ 和 $2.4$,取 $2.4$;负优势 $\hat A_t=-2$、$\rho_t=0.6$ 时,两项分别为 $-1.2$ 和 $-1.6$,取 $-1.6$。裁剪限制的是训练目标,不是直接截断模型输出的概率。这里比较的是当前 Actor 与采样旧策略;上一节 KL 奖励比较的是采样策略与冻结 Reference,两者用途不同。来源:OpenAI PPO 说明
Critic 同时拟合 $\hat R_t$。基础形式是 $\mathbb E_t[(V_\phi(s_t)-\hat R_t)^2]$;TRL v0.11.4 的实际实现还加入价值裁剪,本文不展开该实现细节。
一轮训练的输入与输出
输入:一批 Prompt;待训练的 Actor、Critic;冻结的 Reward Model、Reference Model。
- Actor 生成回答,保存有效 Token 的旧对数概率和旧价值。
- Reward Model 对完整回答打分,Reference 帮助构造逐 Token 惩罚。
- 用奖励和旧价值计算 GAE 优势及 Critic 目标回报。
- 将同一批数据拆成 mini-batch,多轮更新 Actor 和 Critic;Prompt 与 Padding 不计入回答 Token 损失。
- 用更新后的 Actor 重新采样下一批回答,重复以上步骤。
输出:更新后的 Actor 和 Critic;最终负责生成回答的是 Actor。这个流程解释的是经典实现,不代表所有 RLHF 系统都采用相同的奖励、KL 或价值损失配置。
来源
- Proximal Policy Optimization Algorithms — Schulman 等,2017,PPO 原论文;访问于 2026-09-24。
- Proximal Policy Optimization — OpenAI Spinning Up,PPO-Clip 目标及伪代码;访问于 2026-09-24。
- High-Dimensional Continuous Control Using Generalized Advantage Estimation — Schulman 等,GAE 原论文;访问于 2026-09-24。
- TRL v0.11.4 PPOTrainer 源码 — Hugging Face,旧版 RLHF-PPO 的逐 Token 奖励、GAE 与损失实现;访问于 2026-09-24。
资料核对日期:2026-09-24。